Dashboard site with Hexo and Vega-Lite

最近写一篇论文需要画 10 张实验数据图,我用一套祖传的 Matplotlib 脚本读取 csv 实验数据画图。这个过程有几个很痛苦的问题:

  1. 实验数据管理比较混乱,例如我可能每次批量做实验只会更新表格的一行/一列,csv 又没有注释,到后面就忘记每行是什么时候做的了
  2. 每张图的样子都不太一样,并且脚本代码高度耦合,所以基本上我为每张图都要维护一个脚本
  3. 我和合作者希望能在线实时共享实验数据

为了解决 3,我们日常在用飞书智能表格的仪表盘功能登记数据,但它的格式无法定制而且比较丑,导致用在论文里的图还得重新画。并且没有历史记录功能,也就是解决不了 1 和 2。

我尝试为这三个问题寻找成熟的解决方案。对于问题 1,直观的解决方案就是用 Git 对 csv 进行版本管理;实际上这还有一点小问题就是 csv 的修改有时是和画图脚本绑定的,也就是 csv 和画图脚本需要同时做版本管理。这就来到了问题 2,我认为我们 csv 入图片出的流程是没有问题的,但这个转换流程的实现不够理想,理想情况应该存在一个 markup language,描述数据到图片的映射过程,对这个 markup language 做版本管理就比管理画图脚本要美丽的多。ChatGPT 告诉了我 Vega-Lite 这个项目,我认为它完美地做到了我需要的事。问题 3 解决方案就比较多了,无非是创建一个网站,我最熟悉的就是 Hexo 引擎。

他们结合在一起之后,就得到了一个我非常喜欢的、有点 Unix 哲学的工具链(do one thing and do it well):用 Hexo 生成静态网站,用 Vega-Lite 描述图片格式,用 Git 对源数据和图片格式做版本管理。它被实现为我个人博客主题的一个特性。

Preview

欢迎使用!

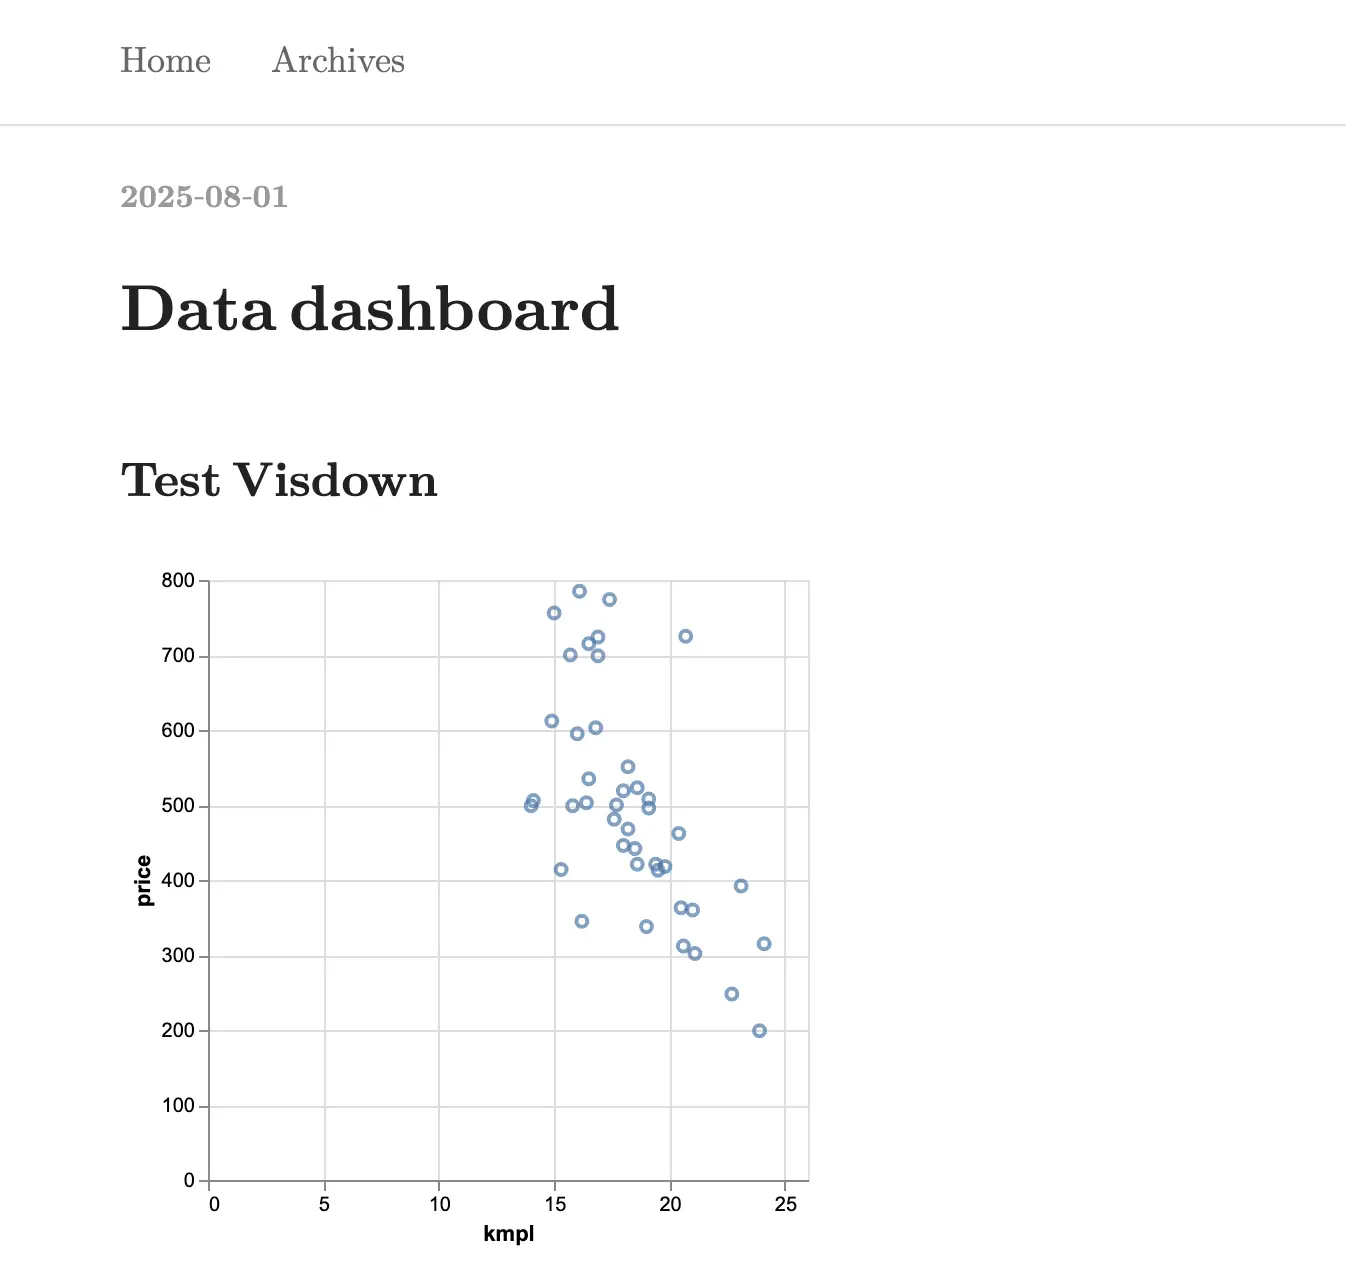
使用流程就是写一篇普通的博客,插入一个代码块,指定语言为 vega-lite:

```vega-lite
data:
  url: /data/cars.csv
mark: point
encoding: 
  x: 
    field: kmpl
    type: quantitative
  y: 
    field: price
    type: quantitative
```

然后创建一个 source/data/car.csv 文件:

brand,model,price,kmpl,bhp,type
Chevrolet,Beat,421,18.6,79,Hatchback
Chevrolet,Sail,551,18.2,82,Sedan
Chevrolet,Sail Hatchback,468,18.2,82,Hatchback
Chevrolet,Spark,345,16.2,62,Hatchback
Fiat,Linea Classic,612,14.9,89,Sedan
Fiat,Linea,700,15.7,112,Sedan
Fiat,Punto Evo,499,15.8,67,Hatchback
Ford,Classic,506,14.1,100,Sedan
Ford,Figo,414,15.3,70,Hatchback
Honda,Amaze,519,18,87,Sedan
Honda,Brio,421,19.4,87,Hatchback
Hyundai,EON,302,21.1,55,Hatchback
Hyundai,i10,418,19.8,68,Hatchback
Hyundai,i20,523,18.6,82,Hatchback
Hyundai,Verna,774,17.4,106,Sedan
Hyundai,Xcent,496,19.1,82,Sedan
Suzuki,Alto,315,24.1,67,Hatchback
Suzuki,Alto 800,248,22.7,47,Hatchback
Suzuki,Celerio,392,23.1,67,Hatchback
Suzuki,Ciaz,725,20.7,91,Sedan
Suzuki,Estilo,338,19,67,Hatchback
Suzuki,Ritz,442,18.5,86,Hatchback
Suzuki,Swift,462,20.4,83,Hatchback
Suzuki,Swift DZire,508,19.1,86,Sedan
Suzuki,SX4,715,16.5,103,Sedan
Suzuki,Wagon-R,363,20.5,67,Hatchback
Nissan,Datsun GO,312,20.6,67,Hatchback
Nissan,Micra,413,19.5,67,Hatchback
Nissan,Sunny,699,16.9,98,Sedan
Renault,Pulse,446,18,74,Hatchback
Renault,Scala,724,16.9,98,Sedan
San,Storm,595,16,59,Sedan
Skoda,Fabia,503,16.4,75,Hatchback
Skoda,Rapid,756,15,104,Sedan
Tata,Indigo,499,14,65,Sedan
Tata,Nano,199,23.9,38,Hatchback
Tata,Zest,481,17.6,89,Sedan
Toyota,Etios,603,16.8,89,Sedan
Toyota,Etios Liva,500,17.7,79,Hatchback
Volkswagen,Polo,535,16.5,74,Hatchback
Volkswagen,Up,360,21,74,Hatchback
Volkswagen,Vento,785,16.1,104,Sedan

原本代码块的位置就会变成一张数据图,效果如下:

visdown preview

Future Work

我还没有重度使用这个工具链,所以暂时还是不知道版本管理的负担有没有变轻,以及这样的静态网站是否真的能满足共享数据需求,但总体而言他目前的样子我很喜欢,并且图片调好之后基本可以直接放到论文里用(但还需要根据论文排版调整一些大小/比例之类的)。

Do one thing and do it well 也不一定永远是好的,因为 thing 的定义可能很善变,例如我可能有一天会想对比两个 git 版本的图到底区别如何,hexo 看起来就不能很方便地做好这件事情。再比如 dashboard 可能需要布局来在一屏之内放尽可能多的图,这对我的博客主题而言也很难实现。

现在已经可以导出 svg,但 LaTeX 里用的话还需要转换成 pdf,转换成 pdf 并裁切的功能应该比较实用。

Profiling with Perf

有一个很好的参考资料 perfwiki。

perfwiki 的组织方式是从 perf 的实现原理出发,先讲 perf 提供了什么手段,再举例子讲能用来干什么。即先讲 perf profiling 过程中最重要的对象 event,然后 perf stat 就是执行程序前后 event 数量之差,perf record 就是执行程序过程中事件每发生固定次数就采集一个样本。这个角度 perfwiki 做得很好了,本文尝试换一个角度组织,先讲有哪些 profiling 任务,再讲用户可能希望一个 profiling 工具提供哪些功能,最后映射到 perf 的实现上。理论上这种结构可以落实到多种 profiler 实现上,但我其实没用过其他 profiler(挖坑)

识别性能瓶颈

最经典的任务是将 CPU 执行的时间按“CPU在执行哪个函数”进行划分,然后查看哪些函数用时最长,然后着力优化这些函数。实际上还有其他类型的性能瓶颈,例如 Top-down 将 CPU uop-slot 按“等前端、等后端、执行错误的分支、正常执行”进行划分,或者有些性能瓶颈是多核间在等锁,CPU 大部分时间其实在等锁,但我们看到 “CPU 在等待”这个信息其实没啥价值,等等。

最直觉的做法是进出函数时都打印带时间戳的日志,然后分析日志来统计每个函数的执行时间。这种做法有其优势:日志内容运行时可控,例如可以记录下函数参数和返回值,这些日志可以同时用于 debug。但显著的问题有两点:

  1. 需要主动知道哪些函数是潜在的热点需要被记录,然后手动为他们写日志语句;或者需要一个额外工具来自动为所有函数插入这种日志;更进一步,这两点在没有源码时都不现实;
  2. 当函数调用次数过多时,记录这些日志本身可能会成为性能瓶颈,因为这涉及格式化、与硬盘交互等等;

幸运的是,有一个非常聪明的思路同时解决了这两个问题,就是把“CPU在执行哪个函数”看作一个概率分布,然后对他进行采样。只要采样频率足够,就能足够逼近原始分布。并且,如果一个地方是性能瓶颈,他在原始分布中应该占比很高,所以不用担心采样过程中漏掉它。

实现这种采样有两个要点。(1)实现固定间隔发起采样事件,这在 perf 里用 perf record 实现。这个命令做的就是固定间隔采样。这里的间隔具体的定义是 event 数量间隔,当事件为 cycles 时,固定 event 数量间隔就对应于固定执行时间。-F 参数可以指定采样频率,-a 参数指定对所有 CPU 采样,-C 参数指定了要采样的 CPU 列表。(2)每个样本内需要记录 CPU 在执行哪个函数,更好的情况是知道当前调用栈。-g 参数就告诉 perf record 记录下调用栈,这里记录的只是每层调用栈的返回地址(挖坑:调用栈的栈帧,以及这里记的是不是返回地址),把它翻译成函数符号是后续工作。这个命令对整个 CPU 采样,所以可能会采到其他进程。可以直接把执行其他进程的样本剃除,或者给 perf record 加上 -p 参数,考虑到 perf record 的意义是对概率分布进行采样,这么操作没什么问题。

perfwiki 中指出,现代 CPU 的实现方式导致采集到的样本的指令位置可能并不精准地是 event 数量间隔到达的那一刻,会有偏移(skid)。当事件为 cycles 时这不是太大的问题,但事件是 cache-miss 等时就要注意精确的样本位置不能用来参考。

perf record 采集到的样本内容是二进制的,用 perf script 处理后长下面的样子:(TODO: 换一个简单的程序,不要用cpu-clock)

zebra 2228528 [007] 196350.576148:   10101010 cpu-clock: 
            72be3b6fa59f __libc_calloc+0x7f (/usr/lib/x86_64-linux-gnu/libc.so.6)
            72be3bacf581 listnode_add+0x61 (/usr/lib/libfrr.so.0.0.0)
            5ebb25f4c736 rib_meta_queue_early_route_add+0x16 (/usr/lib/frr/zebra)
            5ebb25f10345 zread_route_add+0x1a5 (/usr/lib/frr/zebra)
            5ebb25f14046 zserv_handle_commands+0x116 (/usr/lib/frr/zebra)
            5ebb25f83780 zserv_process_messages+0x100 (/usr/lib/frr/zebra)
            72be3bb25854 event_call+0x84 (/usr/lib/libfrr.so.0.0.0)
            72be3bacec78 frr_run+0xc8 (/usr/lib/libfrr.so.0.0.0)
            5ebb25ee3bc6 main+0x3e6 (/usr/lib/frr/zebra)
            72be3b67dd90 __libc_start_call_main+0x80 (/usr/lib/x86_64-linux-gnu/libc.so.6)

bgpd 2225676 [006] 196350.576150:   10101010 cpu-clock: 
            75d5018c01dd __tls_get_addr+0xd (/usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2)
            75d501851d68 socket+0x4ee (/usr/lib/libpreload.so)
            75d501851efe socket+0x684 (/usr/lib/libpreload.so)
            75d501710ec2 event_fetch+0x322 (/usr/lib/libfrr.so.0.0.0)
            75d5016bac83 frr_run+0xd3 (/usr/lib/libfrr.so.0.0.0)
            574331820f53 main+0x393 (/usr/lib/frr/bgpd)
            75d5012bad90 __libc_start_call_main+0x80 (/usr/lib/x86_64-linux-gnu/libc.so.6)
...

采到样本之后展示性能瓶颈有几种方式,我最喜欢的是火焰图(flamegraph)。这个项目画火焰图的方法很直白。首先获得调用栈,对上面的输出做简单的文字处理就能得到下面的内容,它按照字典序(而非时间序)排序,并且调用栈相同的样本被合并:

bgpd;__libc_start_call_main;main;frr_run;event_fetch;socket;socket;__tls_get_addr 10101010
zebra;__libc_start_call_main;main;frr_run;event_call;zserv_process_messages;zserv_handle_commands;zread_route_add;rib_meta_queue_early_route_add;listnode_add;__libc_calloc 10101010
...

一般要做 breakdown 的话调用栈就是这样从 main 开始逐渐细化即可。效果如下:

TODO

理解这个图的方式是:第 k 层的宽度代表了 CPU 处在这个函数内的时间比例,第 k+1 层可能有多个被调用的函数,他们之间的关系也就显示了这个函数内部。画这个图的方法就是,如果两个样本第 k 层相同,就把他们在第 k 层连起来。

还有有一种 reversed 火焰图,火焰图最宽的部分是最后被调用的函数,然后它的宽度被分成它的每个 caller 分别占据多少比例。在确定了某个热点函数后,如果这个函数有多个 caller,这个图会很有用。效果如下:

一些经典的系统idea

类似于 CS61C 提出的体系结构经典 idea,我也想在这里总结一下我在学习/读论文过程中看到的可复用的 idea。很多文章就是对这些 idea 进行排列组合,用于实现 tradeoff 的一部分,实现整体的性能目标。

Read More

6.824 Lab2B Raft

2022.12.18 完成了 Lab2B,内容是实现 Raft 的共识算法。经过 200 轮测试的检验没有发现问题,我就当作实验完成了。这里记录一下过程中发现的比较有意思的 bug。它们不一定很难修改,很多也都明确地写在 Raft paper 的 Figure 2 中,但是去思考它们为什么会导致错误,什么情况会触发这些错误,是很有意思的一件事,并且能帮助我们更好地理解 Raft 这个系统,想到读 paper 时没有想到的问题。

Livelock

有时会发生这种情况:系统虽然在线,但不再做有效的工作,连心跳都不发送。打印许多日志后发现集群(由3台机器组成)一直在选举,而且永远是同一个机器竞选,而另外两台机器拒绝投票,因为 Candidate 没有通过 up-to-date 检查(Raft paper 5.4.1)。这个 bug 错在 RequestVote RPC 的接收方不加判断地更新重新选举定时器,正确地做法是仅在投票时更新定时器,拒绝投票时不更新定时器,来保证自己可以正确地超时、启动竞选。在这里,Candidate 没有通过任何 Follower 的 up-to-date 检查,说明它无法竞选成功,要使系统继续工作,需要另外两台机器之一超时启动竞选。

类似地,AppendEntry RPC 应当在 RPC term 没有过期时更新定时器。注意这不要求 RPC 成功,因为 RPC 可能因为 log 不一致而失败,这时 Leader 会自减 nextIndex[] 并重试,这仍然构成一个 Heartbeat,应当更新定时器。

错误地认为 log 冲突导致不必要的删除

在 Raft Paper Figure 2 中,AppendEntry Step 3是:

If an existing entry conflicts with a new one (same index but different terms), delete the existing entry and all that follow it.

我曾经在比较 term 时出错,用 existing entry 的 term 与 AppendEntry 的 term 比较了,正确的做法与 AppendEntry 中新的 Log Entry 的 term 进行比较。这可能会导致不必要的删除日志,因为传输的新 Log Entry 不一定是当前 term 的内容,也可能是之前 term 的内容。

这会导致问题的场景是:如果 AppendEntry 在网络中经历了较高的延迟,RPC 可能已经过期,正确做法下两条 log 不会冲突,所以不会删除,而这个错误会导致删除这条以及其后所有的 log,而我们很可能之前已经告诉了 Leader 我们拥有那条 log。如果集群中拥有这条 log 的机器数刚好过半,Leader commit 并应用到状态机上,这时我们删除了这条 log,拥有 log 的机器数就不再过半。如果此时 Leader 再离开集群,重新选举的 Leader 就不一定包含这条 log 了(正常情况下,新Leader 包含这条 log 这件事由 5.4.1 的 up-to-date check 保证)。也就是 committed log 被回滚了。

助教的这篇博文也提到了这一问题。

这个 bug 是我阅读代码发现的。这可能并不好测试,根据我的理解,6.824 的测试用例并没有模拟乱序的网络通信。

CommitIndex 的激进更新导致某些机器做出错误 commit

问题在于:TestBackup2B 会有很小的概率失败,原因是某台机器作出的 commit 和其他机器已经作出的不一致。这个问题困扰了我很久,直到我离开电脑准备睡觉时才想到这个问题可能的原因。在 Raft Paper Figure 2 中,AppendEntry Step 5 是:

If leaderCommit > commitIndex, set commitIndex = min(leaderCommit, index of last new entry).

这个 new 很重要,我的错误在于直接用 log 长度更新 commitIndex,正确的做法是用 AppendEntry RPC 中携带的最新 Entry 的下标来更新 commitIndex。这会导致 commitIndex 的更新过于激进,后面的尚未确认与 Leader 同步的 log 也会被 commit。这看起来应该经常出错,为什么在 TestBackup2B 中很少出现呢?因为带有错误 log 的机器在连接到正确集群时,Leader 会不断地自减 nextIndex[] 并重试 AppendEntry RPC,直到在某处 Log 吻合,这时该 Leader 会第一次更新该 Follower 的 commitIndex。commitIndex 首次被更新时 AppendEntry RPC 通常携带新的 Entry,而这个 Entry 和 RPC 接收方的 log 是冲突的,所以 log 都在步骤 3 中被清空了,于是步骤 5 中 index of last new entry 也就是 log 的长度。那什么时候才会触发这个错误呢?答案是 commitIndex 首次被更新时接收到的是心跳(不带 Entry 的 AppendEntry RPC),它不会清空后面的错误的 log,而且还会更新 commitIndex。这就要求心跳刚好在 nextIndex[] 减少到正确值的时候发送,所以出现的概率很低。

要定位这个 bug 还是很困难的,因为这个问题出现的概率真的很低(跑50次出1次问题左右),每跑一次都需要等很久,而且每次 commit 都打印一条信息导致输出很长。推荐一篇文章:Debugging by Pretty Printing,是 6.824 的一名助教写的,帮助我们更好地用日志调试分布式系统。

Committing entries from previous terms

我在 Leader 上的 CommitIndex 更新采用的方法是:找 matchIndex[] 中第 n/2+1 大的数。这时要注意:这条 log 还需要属于当前 term,否则无法宣布 commit。也就是不能 commit 之前 term 的日志。原因在 Raft paper 的 5.4.2 节和 Figure 8 中有详细说明。

复读大三

开学的时候,我感到很想完成几门早有耳闻的北美CS课程的实验:6.s081(MIT操作系统课),cs144(斯坦福计算机网络),15-213(CMU计算机系统结构),6.824(MIT分布式系统),构建一个真正 work 的系统,同时认真把它搞透。于是想到了一个命题:我大四课这么少,用来复读大三怎么样?如果大三可以重来,我会做些什么呢?

目标

考虑到我同时需要科研以及工作效率并不如想象中高,我定下了一个(看起来)可行性很高、实现后也很有收获的目标:完成 6.s081,cs144,15-213 三门课程的实验。完成质量需要比较高,这里提出几点要求:

  1. 严格按照要求完成实验,主要关注分数要求(所有通过性测试必须通过,跑分性测试达到较高分数线)和任务点要求(如 6.s081 的“两个功能选择一个实现”不能不选)
  2. 清楚明白地了解自己在做什么,不能做完实验还感到有哪里含糊、不清楚。如果有疑问,至少需要具体地列出来,并在能力范围内尝试解决

更高的要求包括:阅读源码,从零复现系统。不做硬性要求。

视前几周的精力情况决定要不要做6.824,第二周需要先尝试起来,把 Raft 的论文读起来。

计划

目前的计划:每周每门课一个lab(除 6.824 外)。第一周已经做完了 cs144 Lab0-2,6.s081 Lab0,15-213 bomb lab(4/6)(data lab以前做过,不再重做),6.828 lab1 是以前做过的。按照第一周的进度来看,这个计划还是很有希望按期执行的。不过预测后期难度会增加,尤其是 OS…如果出现这种情况,可以2周/1.5周一个lab。

如果计划理想进行,到了中后期 cs144 就做完了,可以投入更多精力做 6.824。

注意到这里没有编译原理,有点尴尬…其实我是很想手搓编译器的,而且不想用 yacc/bison。除开科研可能需要的编译知识之外,它的优先级可能和分布式系统相同,暂时先不列入计划,执行一段时间上面的计划再重新考量。这个重新考量不晚于第三周周末。

本文每周一更新。


进度记录

2022.9.20

这周突然特别想手搓OS,所以进度甚至比预想的还慢…cs144和6.s081推进了一个实验没有问题,但是csapp没有做。这周目标和上周一样,其中csapp的目标是做完bomb lab并再做一个。不过手搓OS进度还挺好的,快要进入用户态了。

2022.12.18

成功地复刻了之前的每个学期都没能坚持学完网课的历史…好在这学期不是一事无成,这里来总结一下。

手搓 OS 在虚拟机里已经跑得很不错了,有了用户态、多进程、系统调用、文件系统、终端。下一步工作包括文件系统的写出,多核调度与内核锁,搭建测试框架。尝试了 USB 驱动,但是比较困难,暂时放下。

bomb lab 做完了,但也就止步于此。其他 lab 没做。

6.824 lab 2B 今天刚刚做完,通过了 200 轮测试,感觉神清气爽啊。

科研方面在做一个DSL,DSL编译后会生成一套网络协议栈的源码。已经在实现“编译后”的系统原型了,目前只差定时器和拥塞控制了。通过阅读 RFC,对 TCP 的理解比大三上课时高了不少。

6.824 Lab1 MapReduce

前前后后做了15个小时,看到PASSED ALL 30 TESTING TRIALS的那一刻,太爽!

概述

这个实验要求实现经典论文MapReduce的模型。MapReduce在Google内部是跑在一个服务器集群里的,这些服务器共享一个分布式文件系统GFS。这个实验只要求实现运行在本机多个进程上的、本地文件系统上的MapReduce模型,省去了与分布式文件系统的交互(要做负载均衡这个很重要,而且应该很麻烦)。

实现过程流水账

先读论文花了3h左右,内心活动:这论文真简单。

然后开始实现。我并不会go语言,官网那个tour我也就做了一点点,事实证明全做完比较省时间。第一次写的代码全是if-else,我还没有加入容错机制的时候代码已经复杂到我读不懂了。内心活动:工业界实现这玩意的人是神仙吧!然后我把3个小时码的200多行代码全都回滚掉了:-(

第二次写代码之前,我决定写一个类似于有限状态自动机的东西。事实证明这个模型还不错,让我的思路变得比较清晰,并且便于拓展。然后花了2h画图+搭框架,就是只写了一堆switch-case,每种状态对应的转移和转移前需要进行的操作的注释。然后就头晕,下班了。

今天是第三次碰这个东西,今天如果再自闭我可能就要对这实验产生心理阴影了。好在我上次的DFA没啥大问题,只是有些corner case没想到,缝缝补补搞了一段时间。终于把注释转换成了代码,最戏剧性的一刻来了:开码10小时后我终于进行了第一次编译!我以为会得到巨长无比的报错,结果报错就八九行。然后就是改完一行错再出现一行错,改完“最后一行”错之后又蹦出来十几个错误,改了若干年……通过编译之后,他在起始状态就出错了……然后又改了若干年,终于输出了结果。

第一个教训:把语言学明白,勤编译勤测试。

我查看输出文件的前三行(共两万行),发现与标准输出一样!然后高兴地去跑测试脚本,结果第一个正确性测试点就挂了……

第二个教训:测试要认真严谨。

然后又改了若干年,期间多次翻阅论文,发现人家写进论文的东西都是经过取舍和迭代的,还是非常精华的。后来就是无限改bug,调试,按下不表。终于在今天码代码的第8小时通过了所有测试!

做的不错的地方

  1. 画DFA
  2. 头脑不清楚的时候出门转转,可以花掉长达20分钟的时间,但是回来之后你就复活了!

想要做得更好的地方

  1. 阶段性编译、测试。例如我的DFA设计好了,这时候就可以测试下转移有没有问题,然后再在转移前后加功能。
  2. 有设计测试点的能力。对于这个实验,我是用户,而且一定程度上可以说是赶时间,所以用老师的脚本来测试、调试没有什么错。但是一旦成为真正意义上的开发者,bug都要自己找(不提开源社区之类),需要有能力设计若干测试来检验自己的代码在各方面的正确性/性能。这确实需要写一些“没用的”代码,但是它们通常很简单,而且很有用(如算法竞赛里的对拍程序和暴力程序)。例如,我尽管知道各个操作的时间/空间复杂度,但还是不知道我这个实现并发性如何,究竟有多少CPU时间是overhead。
  3. 证明我的DFA的正确性
  4. Challenge
  5. 阅读老师的测试脚本,学习写脚本

CF Edu123 题解

F. Basis

题面

考虑一群在操作 2 下可以互相变换的数组,在其中可以取一个代表元$arr$。假设$arr$由$i$种数字组成,把$arr$中数字$j$所在的下标的集合记作$S_j$,则这一群数组可以用集合的集合$\{S_1,S_2,...,S_i\}$来表示,称为一个原型。如果只能做操作2,答案就是第二类斯特林数$\left\{n\atop i\right\}$的前缀和(对$i$从1加到$\min(k,n)$)。出于后面的实现方便,将对$i$从2加到$\min(k,n)$的前缀和记作$A(n)$。这可以用$O(n\log n)$的复杂度来求,具体见oi-wiki。

接下来考虑操作1。我们发现刚才找到的那些代表元当中有些可以经操作1生成,现在来删除它们。将原型$arr$改写成连续的相同数个数的数组的形式,记作$arr'$,例如将$1,1,2,2,3$改写成$2,2,1$。

  1. 如果$arr'$只有一个数,就是说$arr$中全都是相同的数字,我们发现$arr$一定可以由某个改写前有至少两个不同数的原型经一次操作1:$F(a, n)$生成,于是不用对$arr$计数。也就是说,题目中给的$k>1$时,不用考虑这种情况。如果$k=1$,输出1即可。
  2. 如果$arr'$不只有一个数,去掉$arr'$的最后一个数,考察前面的那些数。如果它们的$gcd$不为1,则$arr$可以被别的原型由操作1生成,不用对$arr$计数。对一个$gcd$,有$A(\lceil {n\over gcd}\rceil)$个原型可以被别的原型$a$生成(将$arr$中每连续$gcd$个数绑定,再计算原型数,也就是$A(\lceil {n\over gcd}\rceil)$)(注意$A$是从2开始加的,因为数字全部相同的原型并不能由操作1生成$arr$)。如果这个$gcd$是合数,可能这些冗余数组会被它的因子删除多次,需要控制这个次数,解决方法是用mobius函数。就是说:对$gcd$,我们计$\mu(gcd)$次$A(\lceil {n\over gcd}\rceil)$。

这里的mobius函数就是在对$gcd$的质因子集合$S$做容斥:质因子集合$S$的子集$S'\subset S$可以与那些各质因子至多出现一次的$gcd$的因子建立一一映射,一个子集中有奇数个因子就取$-1$,偶数个因子就取$1$,有质因子出现2次就取0。子集为空集时(对应于因子1)也取1。

对一个给定的$gcd$,那些能经操作1:$F(a, gcd)$生成的原型,也可以被$gcd$的因子$d$们经操作1:$F(F(a,d), gcd/d)$生成。每个这样的原型被计了多少次呢?答案是

$$\sum_{d|gcd}\mu(d)=\sum_{S'\subset S}(-1)^{|S'|}=\sum_{i=0}^{|S|}\binom{|S|}{i}(-1)^{i}\times 1^{|S|-i}=(-1+1)^{|S|}=[gcd=1] $$

也就是实现了,若$arr'$除去最后一块外的所有数互质,$arr$就属于基,否则不属于,这结束了我们的讨论。关于$0^0$不等式和$[gcd=1]$的讨论可以和Trie树维护集合相交性相类比。最后的答案是:

$$\sum_{gcd=1}^n\mu(gcd)A\left(\left\lceil\dfrac{n}{gcd}\right\rceil\right) $$

直接整除分块求这个东西的一个上界是

$$O(\sum_{gcd=1}^n\dfrac{n\log n}{gcd})=O(n\log n\sum_{d=1}^n\dfrac{1}{d})=O(n\log^2 n) $$

注意不是$O(n\sqrt{n}\log n)$。我们还可以合并同一个$\left\lceil\dfrac{n}{gcd}\right\rceil$对应的所有$\mu(gcd)$之和,前缀和或者开桶统计一下就行。这时,由于后面那个求和只有其中的$\sqrt{n}$项,可能还达不到$\log n$,可以理解为常数很小的$\log n$(经测试,对$n=10^5$该和为6.83)。

Trie树维护集合相交性

这篇文章讲一个 trick,他可以解决如下问题:

维护一个结构,可以添加和删除集合,可以询问:对询问中给定的新集合,结构中有多少集合与之不交?

用这个 trick,可以在 $O(2^{|S|})$ 的时间复杂度内添加或询问一个集合 $S$ ,所以在多个小集合的时候比较有用。

对两个集合 $A$ 和 $B$ ,考虑 $B$ 的所有子集,维护一个计数器 $cnt$ 。对每个子集 $S$ ,如果它也是 $A$ 的子集,为 $cnt$ 加上 $(-1)^{|S|}$ 。

$$cnt=\sum_{S\subset (A\cap B)}(-1)^{|S|}=\sum_{i=0}^{|S|}\binom{|S|}{i}(-1)^i\times 1^{|S|-i}=(1-1)^{|S|} $$

$A\cap B=\emptyset$ 时形式上是$0^0$不定式,根据定义式计算,发现它有由空集贡献的 1 。于是 $cnt$ 就标志着 $A\cap B$ 是否为空:为空时 $cnt=1$ ,否则 $cnt=0$ 。

现在我们维护一个 Trie 树,每个节点代表一个集合。当添加集合 $A$ 时,给它的所有子集对应的节点权值加一。删除时,就为所有子集对应的节点权值减一。可以注意到空集对应节点的权值就代表当前结构中维护的集合个数。

然后考虑询问:设在询问 $S$ ,对所有 $S'\subset S$,如果 Trie 树中有对应 $S'$ 的节点,就为计数器加上 $(-1)^{|S'|}\times tr ie[S']$。这样,对结构中维护的每个集合,若它和 $S$ 不交,它对计数器的贡献就是 1 ,否则是 0。于是计数器的值就代表了结构中与 $S$ 不交的集合个数。

ARC136题解

这场 ARC 比较考验观察能力,就是找到切入点的能力。我会尽量在题解里给出一个观察的过程,至于证明,比猜到结论简单。这场暴露出来我的容易进死胡同的问题,也可能是人类本质。就是一种思路做不出来的时候跳不出来,思维僵化了。以后训练中得注意对想不出来的题尝试“跳出思维定势”。也可能只是 trick 掌握得不够,导致跳出来也不知道想啥。可以先多积累些思路,毕竟“思而不学则殆”。

C - Circular Addition

题面

收获的思路:

  1. 在差分数组上看区间加减
  2. 问最小操作次数时,找几个下界,尝试证明其最大值可以取到。证明时可以尝试把创造过程逆转为消除过程,因为消除时的信息更多,而创造是在“创造”信息。

我看到了第一个切入点“用差分数组处理区间加减问题”。如果您对这个题毫无头绪,可以先对着这句话看自己能想到哪一步。将目标数组看作环并作长为 $n$ 的差分数组,发现这个差分数组和一定为 0,而且每次操作一定是使得一个数 +1,一个数 -1。显然我们可以通过每次选择一正一负的一对位置操作来得到目标差分数组,操作次数为差分数组中正值之和。

然后我发现过不了最后一个样例,仔细一看发现其实也没能给出前两个样例的具体操作步骤,不太对劲。具体来说,就是可以交换差分数组上的操作顺序来获得额外的“全体 +1”buff,这个信息在差分数组里被丢掉了。从这时开始,我就开始想着怎么最大化这个 buff,以及是不是最大 buff 和零 buff 之间的所有值都能取到,陷入了苦战。

按照题解来讲的话,我们已经观察到了一个操作次数下界,还有另一个显然的下界,就是数组中的最大值。我们猜想:他们中的最大值是可以被取到的。然后反过来想将目标数组变为 0 的过程。我们发现这个思路在近达上一场比赛 ARC135D 中就出现过,需要学习一个。

实际应用中,这种猜想很可能会错,尤其是难题。所以姑且提出一个做题步骤:

  1. 观察总结此前得到的事实,提出猜想
  2. 代入样例,若有误返回1
  3. 尝试证明,若证伪返回1
  4. 如果证明或不会证而自信,开码
  5. 如果没证出来且不太自信,多造点样例,再次手玩或对拍,若有误返回1,否则开码

按照步骤,我们应当代入样例。发现没问题,开始尝试证明。如果我们在每一时刻都能降低这一时刻的“差分数组下界$L_1$”和“最大值下界$L_2$”中的最大值,我们就构造性地证明了猜想的正确性。为了降低最大者,我们需要对$L_1$和$L_2$的大小做出假设来进行进一步推理。

  1. $L_1<L_2$:此时数组中不可能有 0,否则为了从 0 增加到 $L_2$,差分数组中正值部分至少是 $L_2$,这与 $L_1<L_2$ 矛盾。于是全体 -1 即可,这样能使 $L_2$ 减小 1。
  2. $L_1>L_2$:如果数组中有 0,我们只要挑选一段包含最大值的极大非零区间来全体 -1,这样能使 $L_1$ 减小 1。如果数组中没有 0,数组中一定有若干“山谷”,所以一定可以找一段极大的“连续最大值区间”(要求其左右不再是最大值)来减 1,这能使 $L_1$ 减小 1。
  3. $L_1=L_2$:如果数组中有 0,一定是单调增加到 $L_2$ 再单调减小到 0,将非零部分 -1 即可同时减小 $L_1$ 和 $L_2$。如果数组中没有0,数组中一定有若干“山谷”。如果*极大的“连续最大值区间”*唯一,那么将其减 1 即可。否则,一定可以找到一个区间覆盖所有的最大值,例如除去最小值后获得的区间。将这个区间全体减 1 即可。

把这个过程反过来想会变得更难想,尤其是 $L_1=L_2$ 时的操作。所以这个“减小双下限最大值”的 trick 应该被加入知识库。

D - Without Carry

题面

收获:SOSdp

推荐博文:SOSdp,zeta transform 前者为后者前置知识,本题只需要学习前者。但是来都来了,为什么不都学一下呢?

读完博文直接就会做了,不会就看官方题解,不必多说。

E - Non-coprime DAG

题面

收获:我观察能力低下?

  1. 不够耐心,一条思路还没想透彻就放弃
  2. 可以把结论写出来,更容易发现规律,形式的不同会影响思考方式

在看题解之前,您至少应该发现“不可达”和“互质”并不等价,例如9可以经12和14到达35。并且经过了一定的思考。

对 $i<j$ ,考察 $i$ 是否可达 $j$ 。后文同余符号皆模 2 ,$f(i)$ 为 $i$ 的最小质因子。

  1. $i\equiv 0,\;j\equiv 0$,此时一定可达。
  2. $i\equiv 0,\;j\equiv 1$,此时来到了第一个重要观察:可以尝试经过 $j - f(j)$ 这一偶数到达 $j$ ,所以不超过 $j-f(j)$ 的偶数都 ok ,即要求$i\leq j-f(j)$。而比它大的偶数,和 $j$ 的差距已经小于其最小质因子了,没有机会走到 $j$ 了。
  3. $i\equiv 1,\;j\equiv 0$,类似于 2 ,要求$i+f(i)\leq j$。
  4. $i\equiv 1,\; j\equiv 1$,此时来到了第二个重要观察,也是我卡住的地方。由于我没有将上面的观察列出来,我并没有注意经过偶数到达奇数这条路,或者隐约觉得这效率低下。其实这个类比还是比较明显的,大脑好用时起码可以猜一个结论出来。先写结论:$i+f(i)\leq j-f(j)$ 即可。首先,两者都是奇数,这就决定了只加一个(一定为奇的)质因数并不能使 $i$ 到达 $j$ ,至少要加 2 个。如果想由偶数搭桥,显然i -> i+f(i) -> j-f(j) -> j的路径就是最优的。如果不这样做,要么 $i,j$ 有公因子(此时 $i+f(i)\leq j-f(j)$ 必成立,或者仍然可以理解为从偶数搭桥),要么还是需要转到 $j-fac(j)$ 再转到 $j$ ,其中 $fac(j)$ 是 $j$ 的某个因子。而这一个转变最少也要加 $f(i)$ ,转变后最少也要再加 $f(j)$ 到达 $j$ ,本质还是从偶数搭桥。

现在我们获得了“可达”的数学表达。我又卡在这里了(我去想 DAG 了并且没跳出来,悲)。注意到不等号左右的内容都很相似,并且右侧可以加1(因为模2的限制,两式仍然等价),尝试总结为一个式子。可以将不等式变形为:

  1. $i+1\leq j$
  2. $i+1\leq j-f(j)+1$
  3. $i+f(i)\leq j$
  4. $i+f(i)\leq j-f(j)+1$

可以总结为:

$i$ 可达 $j$ $\Leftrightarrow$ $up(i)\leq low(j)$,其中 $up(i)=(i\equiv0)?i+1:i+f(i)$,(注意这个 $+1$ ,这是因为 $i<j$ 不带等号)$low(j)=(j\equiv0)?j:j-f(j)+1$。

再次总结这个表达,对任意的 $i, j$,当且仅当 $up(i)\leq low(j)$ 或 $up(j)\leq low(i)$ 时他们之间可达,用区间语言表达就更干净:$[low(i), up(i))$ 与 $[low(j),up(j))$ 没有交点时可达(注意区间开闭)。于是题目变成:寻找有公共交点的区间族 $\{[low(i), up(i))\mid i\in\mathbb{N}\}$ ,使得 $\sum_{i}A_i$最大。随便做。

ARC135题解

F暂时有个地方没搞明白,但我会研究题解和正确代码,把它搞会。

C - XOR to All

题面

关键在于发现若干次操作一定可以等价于一次操作。

假设进行了多次操作,考察前两次操作$B_0$和$B_1$。由定义,$B_0$一定是原数组中的一个数,而$B_1$一定是原数组中的某个数$A$与$B_0$的异或和,因为$B_1$取自被$B_0$更新过的数组。我们发现$B_0,B_1$两次操作的结果等价于直接用$A$进行一次操作。现在操作次数减少了1,可以一直使用这个方法直到将多次操作等价为一次操作。

现在只需要比较选择每个数对数组元素之和的影响,这可以按位统计做到。对每一位(最多30位)统计有多少个数在这一位是1,然后选择$A_i$对和的影响就是:$A_i$会对数组中所有的数翻转$A_i$中为1的那些位,翻转的贡献可以由统计的数据计算出来。

E - Sequence of Multiples

题面

赛后自己做出来了,很高兴。

下面记题目描述的数列本身为$A_i$,而不论怎样得到它。

初见端倪的朴素算法

观察一个特殊的例子:$X=1,N=1e18$。这时数列就是$1$到$n$本身!然后考察$X=2,N=1e18$,发现数列是$\{2n\}$。继续观察,会总结出一个规律:无论$X$如何,当$n$充分大时,数列会变成$\{kn\}$的形式,$k$为常数。

证明:假设第$n$项是$kn$,那么第$n+1$项的一个上界是$k(n+1)$,这比前一项大了$k$。只要$k\leq n+1$,这个上界就会被取到,因为更小的$n+1$的倍数已经小于第$n$项了,这不符合题目要求。

于是我们发现这个$k$的变化趋势是很重要的,如果我们能搞清楚什么时候$k\leq n+1$,这之后的内容就可以$O(1)$计算了。为了研究它,构造新的数组$\{B_n\}:B_i=A_i/i$。

在特殊例子上构造$\{B_n\}$会给我们一些最基本的认识,例如:$\{B_n\}$是不增的。前面的证明过程稍加修改就能证明这个结论。实际上,我们感到它以类似于反比函数的速度减少。

为了解出$B_i\leq i+1$的时刻,我们研究$B_i$的变化趋势,而这可以其定义中的$A_i$入手,考察$A_i$的变化趋势。我们发现$A_{i+1}-A_i\leq i+1$,否则$A_{i+1}$会被$A_{i+1}-(i+1)$取代。于是$A_i$大致以$O(n^2)$的速度增加,具体来说,$A_i-A_1\leq(\sum_{k=2}^{i} k)=(i+2)(i-1)/2$。

得到了$\{A_i\}$的变化趋势,两侧同时除以$i$即可得到$\{B_i\}$的变化趋势上界:$B_i-\frac{X}{i}\leq \frac{(i+2)(i-1)}{2i}\leq i$,$B_i\leq \frac{X}{i}+i$。这个上界是有极小值的,但我们知道$B_i$不增,所以我们可以先增加$i$得到极小值,然后等待$i+1$追上这个极小值。显然,这个极小值在$i=\sqrt{X}$附近取到,而$i=2\sqrt{X}$时就一定有$B_i\leq i+1$了。于是我们证明了,如果我们暴力计算$\{A_i\}$直到$B_i\leq i+1$,时间复杂度是$O(\sqrt{X})$的。尽管我们没有证明其下界,但这个算法实际效率也不够高,对1e18 1e18的输入需要计算20秒,10组就是200秒,远不是常数问题。

正解

$B_i$有一个类似于反比函数的,一开始快速下降,然后缓慢下降,最后不变的变化过程。对反比函数的取整求和有整除分块,对$B_i$能不能也找到某种分块来合并一些计算呢?